私有化部署模型,正在变成一件平常的事。要让它在整个机构里安全运行,则不然。
Apple、Microsoft 与开放模型生态都在把私有推理变成基础设施,我们预期这个趋势会继续。我们不打算在硬件上跟他们竞争,也不会假装我们在竞争。
不会被商品化的,是模型周围的一切:一次请求可以读取哪些记录、谁有权提问、任何内容保留多久、每一项输出都需经人工审核,以及答案最终落在哪一段工作流程里。这才是我们建造的部分。
在您认定一台笔电就够用之前,有两件事值得知道。
上下文长度。手机或笔电上的设备端模型,上下文窗口通常只有几千个 token,输入与输出共用;云端方案更大,但仍有上限,而且具体数字会随每次系统更新而变动。这些长度足以处理一份文件,但不足以一次读完两年的个案脉络 —— 而那正是最能替团队省下时间的工作。这不代表在贵机构自己的硬件上做不到:检索、分段处理,或改用上下文更长的本地模型都办得到。它代表的是:检索方式、权限、保留规则与审核步骤,仍然需要有人设计。模型只是问题的其中一环,不是全部。
一个人不等于一个机构。Microsoft Foundry Local 的官方文件说明,它是为单一用户的个人设备而设计,多用户的情境应改用服务器端方案。设备端模型给一位同工一个私人助理;它不会给整个机构一份共享、受治理、可稽核的记录访问权限 —— 附带角色权限、保留规则,以及董事会可以查验的稽核轨迹。
我们在自己的场地自建并运营 AI 服务器,让贵机构不必自行处理这件事。若贵机构希望跑在自己的硬件上,或跑在同工手上已有的设备上,我们也一样协助 —— 并会坦白告诉您,三种方式中哪一种真正符合贵机构的治理要求。
您的敏感笔记在我们自己的服务器上处理,不会送到外部 AI 公司。这降低了对您所服务的人的风险。
这是一条路径,不是绑约。许多客户从订阅开始,待治理需求收紧后再迁移至自有基础设施 —— 我们以透明方式为这一过渡定价。
路径 1 是 Trellistry Operations · Private AI —— 平台的第六个模块。路径 2 与 3 属于 Trellistry Private AI Services:不含 Operations 订阅、单独出售的能力建设与专属部署。因此购买专属部署并不等于购买平台授权。
由我们运营、套用您的政策的受治理环境。
建立您自己的能力 —— 服务器、工作站,或您已拥有的设备。
客户自有的基础设施,适用于治理要求如此的机构。
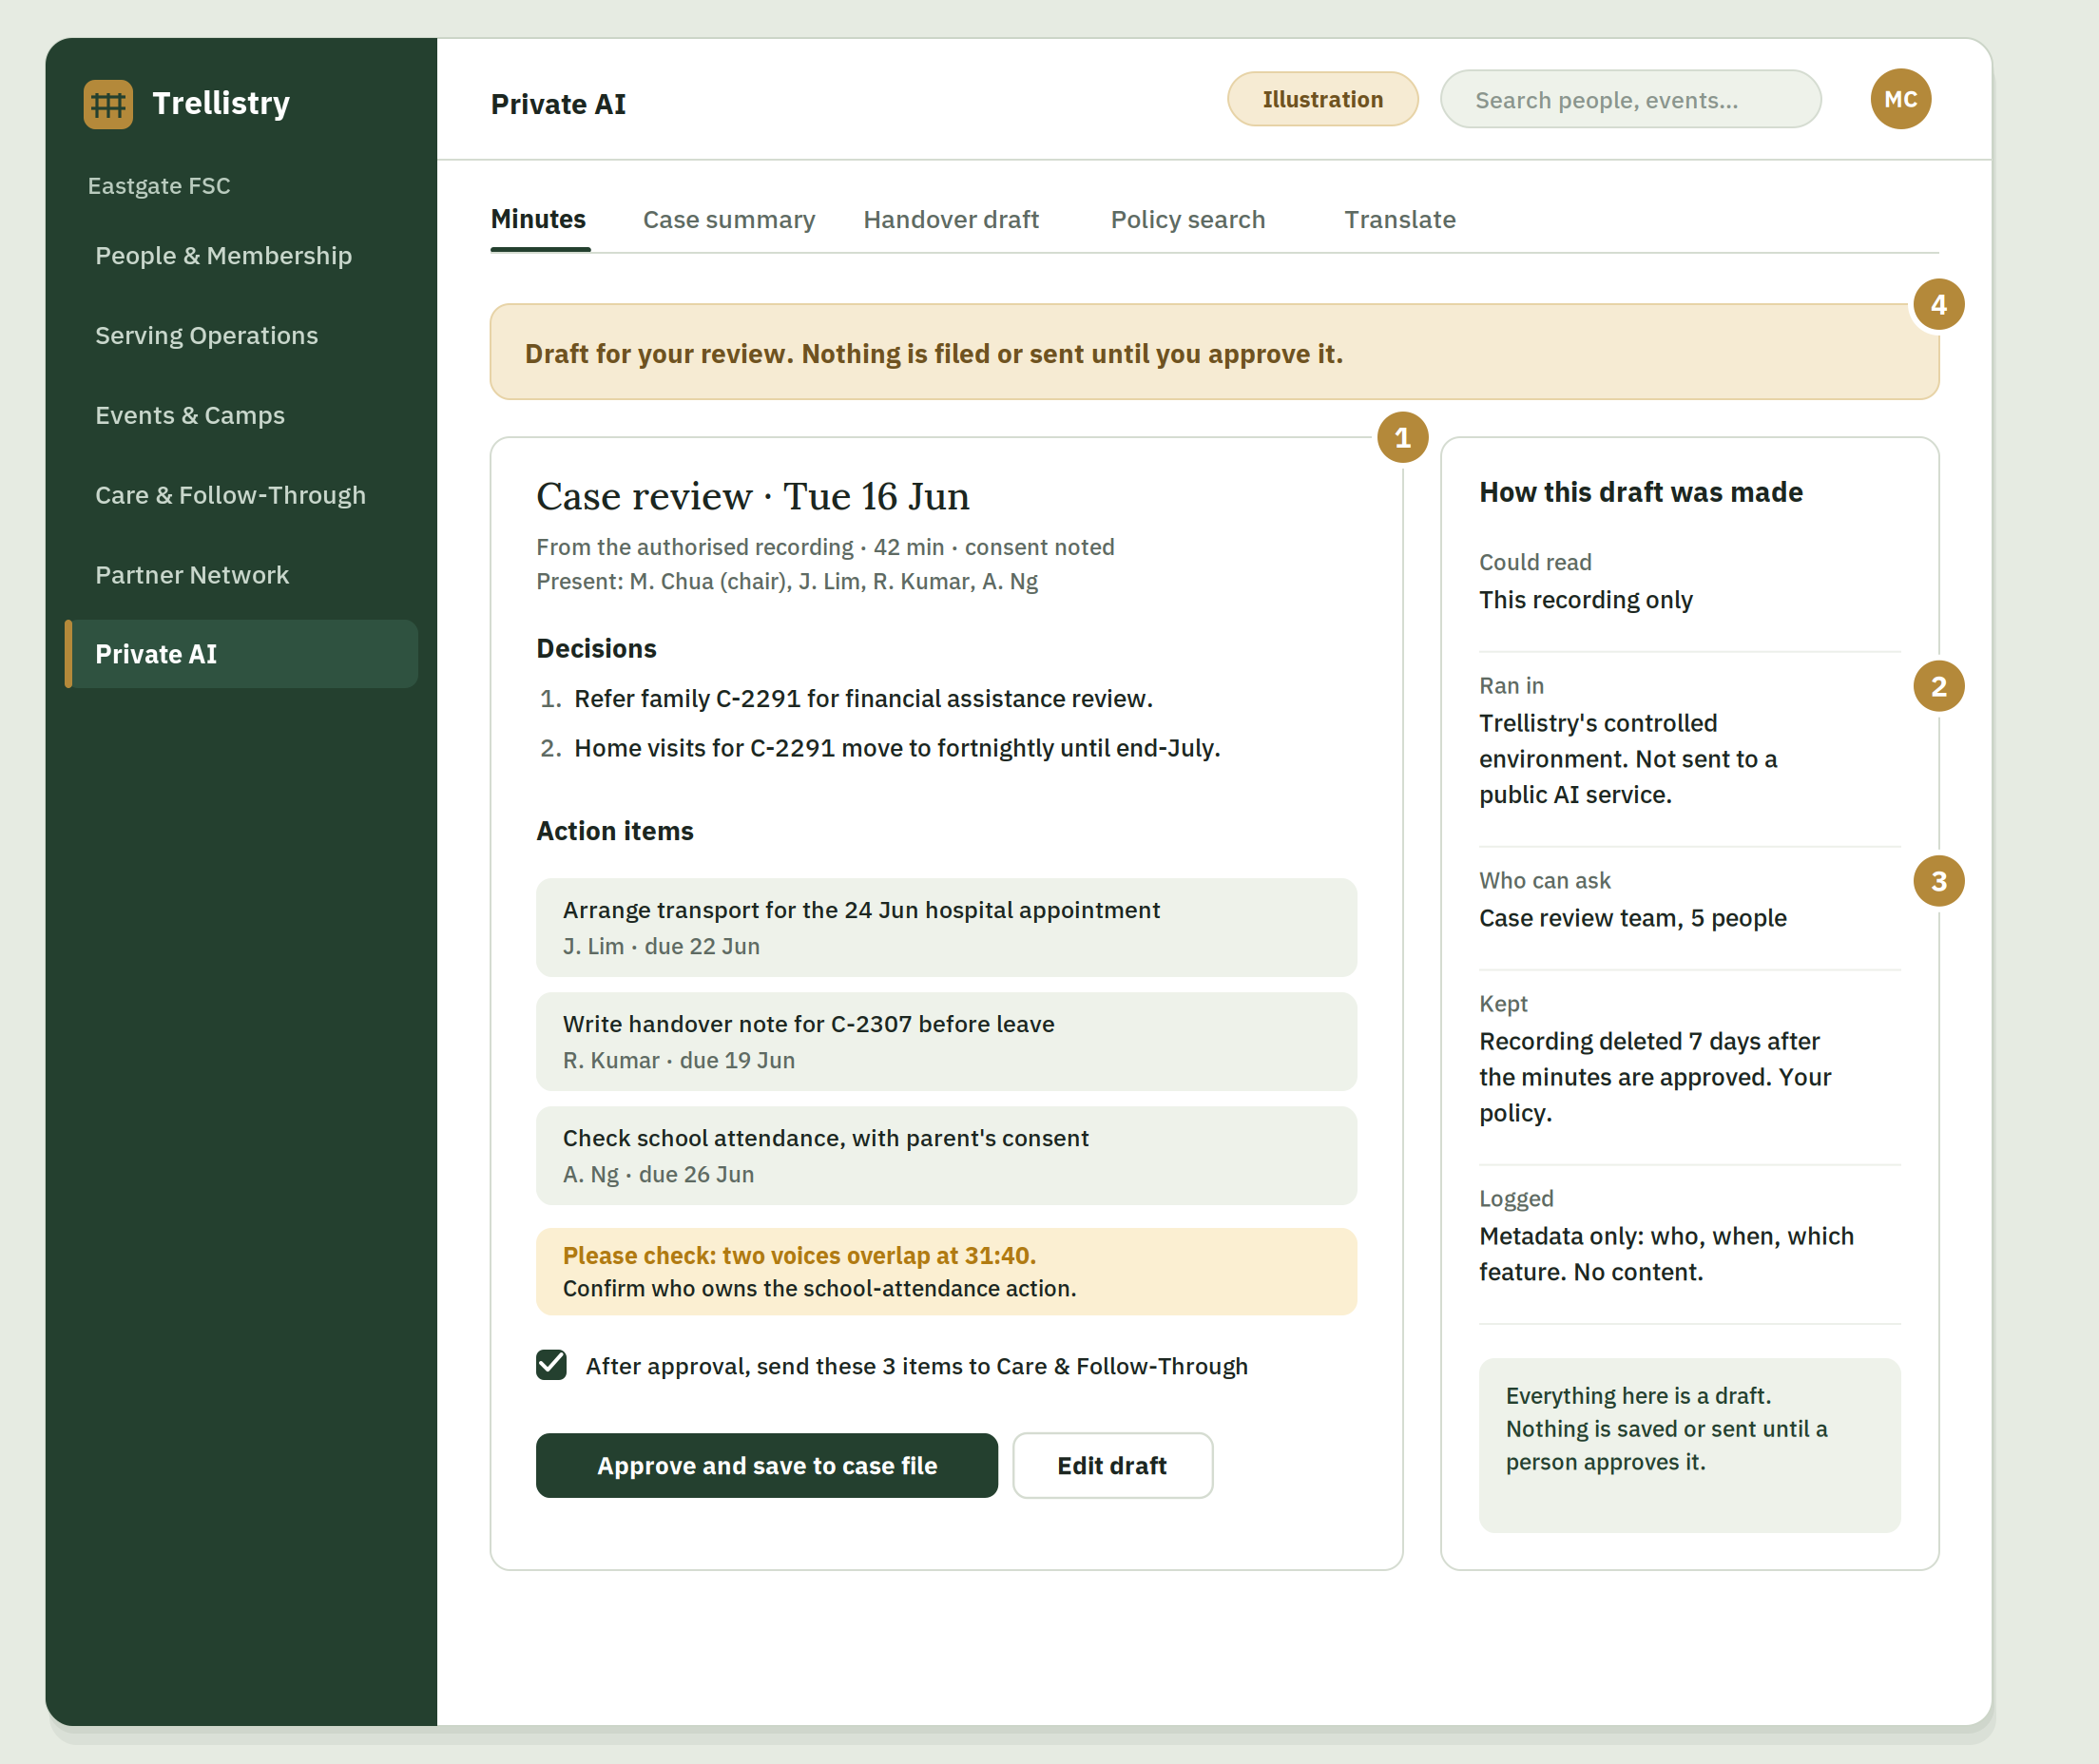
取得授权的录音 → 起草纪要、决议与行动项。
总结个案笔记,并在人员交接时起草交接文件。
依据获批准的内部资料起草 —— 通讯、动态、报告。
用自然语言检索贵机构自己的政策、手册与内部文件。
在不同语言间翻译资源,内容不外泄。
核对与合并表格,生成排程草稿与报告。
每一项 AI 输出都是供人工审核的草稿,绝非权威记录。

全精度推理、足以一次读完整份个案脉络或表格的长上下文、我们自己的硬件,以及没有任何外部 API 调用。具体机型会随更好的模型推出而更换;保证不变。
当前的基础设施细节 —— 机型、精度与硬件 —— 列在我们的安全页面,均经查核并注明日期。
这些问题把隐私上的信念,转成可以查证的东西。向任何供应商都问一遍;以下是我们的答案。
| 问题 | 我们的答案 |
|---|---|
| 内容在哪里被处理? | 在我们自己的本地服务器上,在我们的受控环境之内。 |
| 是否有内容被保留,保留多久? | 内容处理后即丢弃。用量元数据(时间戳、token 数)为计费保留。无内容日志。 |
| 内容是否用于训练? | 否。您的内容绝不用于训练任何模型。 |
| 是否有内容被储存以供检索? | 仅在您用自己的文件配置检索(RAG)时才有 —— 而这些数据留在您的环境之内。 |
| 会否流入未来的模型版本? | 否。我们不以客户数据训练模型。 |
每个方案都有明确的额度 —— 转录时数、模型等级、每月额度、并发用户、存储、支持级别。我们不提供任何「无限」,理由很坦白:这样才能为共用同一套基础设施的所有人保住容量。
最多 5 位用户
S$79/月
最多 20 位用户
S$179/月
最多 50 位用户
S$399/月
50 位以上用户
S$799/月起
这里的 AI 绝不取代牧养判断、儿童保护决定、辅导或属灵分辨。它拿走的是这些工作周围的协调琐事,绝不拿走位于其核心的判断。
我们的隐私论据建立在可引用的公开报道之上,而非空口断言。以下从容陈述 —— 这是证据,不是制造恐惧。
主流供应商为商业与 API 数据公布了「默认不训练」的承诺,符合资格的客户也可申请「零数据保留」控制。但在这些控制获批之前,标准的滥用监控流程仍可能保留输入最多 30 天。若在此期间发生泄漏,或有人在此期间恶意访问,内容仍然暴露。
OpenAI 于 2023 年 3 月披露一个软件漏洞,部分 ChatGPT 用户可看到他人的对话标题;在约九小时的有限时间窗内,部分 Plus 订阅用户的姓名、电邮、账单地址与部分支付卡信息也可能被暴露。
来源:OpenAI 事件说明
荷兰数据保护局已警告,将个人数据输入 AI 聊天机器人本身可构成或导致个人数据外泄事件,并援引已通报的案例,包括一家医疗诊所的员工输入病人医疗数据,以及一名电信员工输入客户地址档案。
来源:荷兰数据保护局公告
2026 年 3 月,两个植入盗取凭证代码的 LiteLLM 恶意版本在公开套件库上架约 40 分钟。当年稍后发布的分析重建出一份暴露数据集,涵盖超过 2,500 个组织与约 434,000 条 CI/CD 流水线,包括云端凭证、SSH 密钥与 AI 供应商 API 密钥。新加坡相关实体,包括上市公司和金融行业企业,出现在重建数据集中 —— 属需要调查的潜在暴露,并非已确认的入侵。
同行评审研究表明,语言模型可以逐字记忆并再现训练数据,包括个人身分信息。Carlini 等人示范了从语言模型中提取逐字训练样本;后续研究则针对多个模型系列(包括某生产版本的 ChatGPT)示范了规模更大的提取,显示仅靠对齐并不能消除记忆。将模型介导的个人信息泄露描述为「纯属假设」是错误的。
这些都不意味着 AI 不可用。它意味着「内容在哪里被处理,谁能看到」这个问题必须有答案。这就是我们存在的意义。
试用三个月。若不合用,我们免费为您修正 —— 或全额退还您的订阅费用,并交还一份干净的数据导出。无任何绑约。
而且它应当比替代方案更省钱。 在您开始之前,我们与您一同议定一条基线:您的团队目前在行政上花费多少 —— 以小时或以金钱计,随您选择用哪一项来衡量。若三个月后这条基线没有下降,同样的退款适用。
适用于 Trellistry Operations 订阅。专业服务按该次委托书面确认的范围承诺。Kingsfold 的会员与订阅属另一项产品,不在本保证范围内。有意了解 Kingsfold 的捐赠者、投资人与支持者,欢迎与我们联络。